Offline-first w Mendix: jak działa synchronizacja i jak uniknąć utraty danych
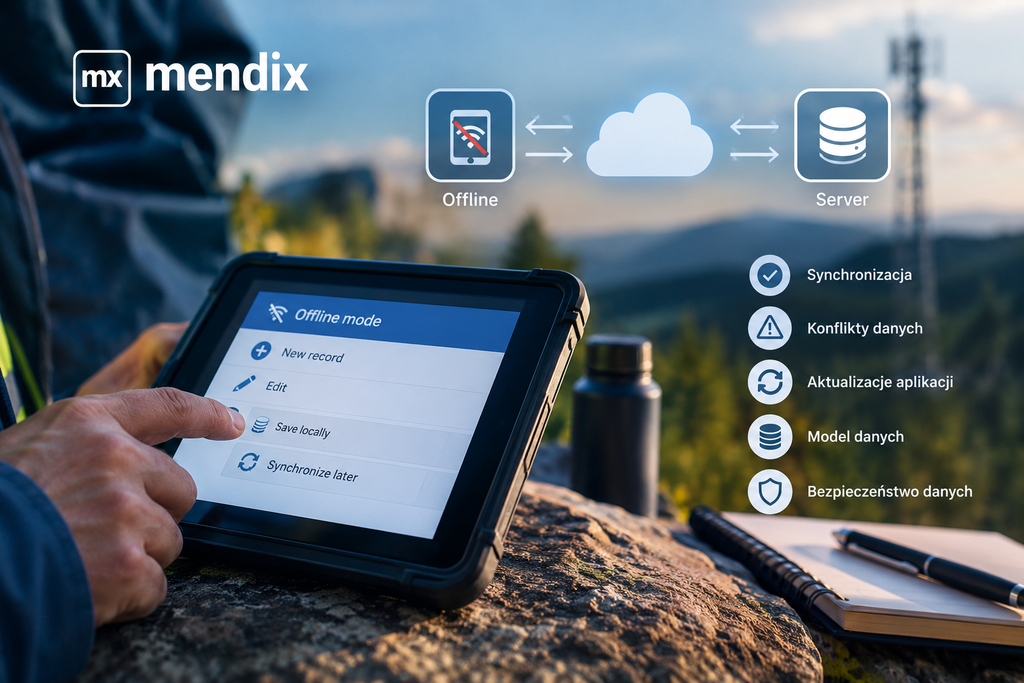
Aplikacje mobilne działające w trybie offline-first brzmią prosto w opisie: użytkownik pracuje bez połączenia z internetem, a dane synchronizują się, gdy sieć wraca.
W praktyce ten model wymaga jednak podjęcia kilku ważnych decyzji. Problemem nie jest samo zapisanie danych lokalnie, ale określenie co, kiedy i w jaki sposób powinno zostać zsynchronizowane. Dochodzą do tego konflikty zmian, aktualizacje aplikacji, zmiany modelu danych oraz sytuacje, w których urządzenie przez dłuższy czas pozostaje offline.
W Mendix mechanizm offline-first daje sporo możliwości, ale wymaga zrozumienia zasad synchronizacji. W przeciwnym razie pozornie poprawna konfiguracja może prowadzić do nieoczekiwanych zachowań, a w najgorszym przypadku do utraty danych użytkownika.
Ten artykuł jest wprowadzeniem do całej serii poświęconej offline-first w Mendix. Zamiast omawiać jeden konkretny scenariusz, pokazuje najważniejsze obszary, które warto przeanalizować podczas projektowania aplikacji offline.
Problem, który wygląda niewinnie
Wyobraźmy sobie aplikację mobilną zbudowaną na Mendix, która pozwala pracownikom terenowym rejestrować dane bez dostępu do internetu, a następnie synchronizować je po powrocie do zasięgu.
Na pierwszy rzut oka scenariusz jest prosty:
- Użytkownik pobiera potrzebne dane,
- Pracuje offline,
- Dane są zapisywane lokalnie,
- Po odzyskaniu połączenia następuje synchronizacja.
Problemy zaczynają się wtedy, gdy aplikacja pozostaje offline dłużej niż kilka minut.
W tym czasie na serwerze mogą zmienić się dane. Może pojawić się nowa wersja aplikacji. Może zmienić się model danych albo logika biznesowa. Ten sam rekord może również zostać zmodyfikowany przez innego użytkownika.
Pojawia się więc kilka pytań:
- Co dokładnie zostanie zsynchronizowane?
- Które dane powinny być dostępne offline?
- Co stanie się z lokalną zmianą użytkownika?
- Co się stanie, gdy ten sam rekord zmieni się również na serwerze?
- Jak aplikacja zachowa się po aktualizacji wersji?
- Czy wszystkie encje powinny być synchronizowane w taki sam sposób?
To właśnie te pytania są istotą projektowania aplikacji offline-first.
Jak działa synchronizacja w Mendix?
Mendix udostępnia kilka mechanizmów związanych z synchronizacją danych pomiędzy urządzeniem a serwerem.
W najprostszym scenariuszu można wykorzystać pełną synchronizację, podczas której dane są wymieniane pomiędzy urządzeniem a serwerem zgodnie z konfiguracją encji i aplikacji.
Przy bardziej rozbudowanych aplikacjach pojawia się jednak potrzeba większej kontroli. W zależności od scenariusza można ograniczać zakres synchronizowanych danych lub uruchamiać synchronizację dla konkretnych obiektów.
Ma to znaczenie szczególnie wtedy, gdy aplikacja pracuje na dużej ilości danych albo wykorzystuje pliki. Nie zawsze potrzebne jest przesyłanie całego lokalnego zbioru danych przy każdej synchronizacji.
Dlatego już na etapie projektowania warto odpowiedzieć na pytanie:
Jakie dane aplikacja naprawdę musi mieć dostępne offline?
To pytanie jest ważniejsze niż samo „czy aplikacja ma działać offline”.
Nothing vs Never — wybór, który łatwo pomylić
Jednym z ważniejszych elementów konfiguracji synchronizacji są ustawienia określające, w jaki sposób dana encja uczestniczy w synchronizacji.
Szczególnie istotne są tryby Nothing (Preserve data) oraz Never.
Ich nazwy mogą sugerować podobne zachowanie, ale mają inne znaczenie. Nothing oraz Never różnią się przede wszystkim tym, czy lokalne zmiany mogą zostać przesłane na serwer.
To istotna różnica, ponieważ konfiguracja encji wpływa nie tylko na to, jakie dane urządzenie pobiera, ale również na to, co dzieje się z lokalnymi zmianami podczas synchronizacji.
Dlatego wybór trybu synchronizacji powinien wynikać z roli danej encji w aplikacji, a nie tylko z tego, czy chcemy „mieć ją offline”.
Co dzieje się po aktualizacji aplikacji?
Offline-first komplikuje również proces wdrażania nowych wersji aplikacji.
W klasycznej aplikacji webowej aktualizacja serwera jest stosunkowo łatwa do wyobrażenia: użytkownik odświeża aplikację i korzysta z nowej wersji.
W aplikacji offline użytkownik może jednak posiadać lokalne dane utworzone kilka godzin albo dni wcześniej. W międzyczasie serwer może zostać zaktualizowany.
Pojawia się więc pytanie:
Co stanie się z danymi znajdującymi się na urządzeniu, gdy aplikacja lub jej model danych zostaną zaktualizowane?
To jeden z powodów, dla których proces wdrażania aplikacji offline-first wymaga uwzględnienia nie tylko aktualnego stanu serwera, ale również klientów, które przez pewien czas mogą pracować na starszej wersji.
Szczególnie interesujące są sytuacje, w których zmienia się konfiguracja synchronizacji albo model danych.
Konflikty danych przy opóźnionej synchronizacji
Kolejnym naturalnym problemem są konflikty.
Załóżmy, że użytkownik pobiera dane na urządzenie i przez kilka godzin pracuje offline. W tym czasie inny użytkownik modyfikuje ten sam rekord w aplikacji webowej.
Pierwszy użytkownik nie wie o tej zmianie, ponieważ jego urządzenie nie ma połączenia z serwerem.
Kiedy urządzenie odzyska połączenie, obie wersje danych muszą zostać ze sobą porównane i odpowiednio obsłużone.
To prowadzi do fundamentalnego pytania:
Co powinno się wydarzyć, gdy dwie strony zmieniły te same dane?
W prostych scenariuszach domyślne mechanizmy synchronizacji mogą być wystarczające. W przypadku danych krytycznych biznesowo może jednak być potrzebna dodatkowa logika pozwalająca wykrywać i świadomie obsługiwać konflikty.
Nie istnieje jedna uniwersalna strategia odpowiednia dla każdej aplikacji. Sposób obsługi konfliktów powinien zależeć od znaczenia danych i konsekwencji ich nadpisania.
Model danych ma znaczenie
Offline-first wpływa również na sposób projektowania modelu danych.
Nie każda encja dobrze nadaje się do bezpośredniej pracy zarówno z poziomu aplikacji mobilnej, jak i webowej. Szczególnej uwagi wymagają dane, które są jednocześnie:
- często zmieniane,
- współdzielone przez wielu użytkowników,
- zależne od innych obiektów,
- istotne z punktu widzenia procesów biznesowych.
Dlatego model danych dla aplikacji offline-first warto projektować z uwzględnieniem faktu, że dane mogą przez pewien czas istnieć w dwóch miejscach: lokalnie na urządzeniu oraz na serwerze.
Istotne stają się wtedy m.in. walidacja danych, relacje pomiędzy obiektami, sposób reprezentowania usunięcia danych oraz sposób przenoszenia bardziej złożonych struktur.
To właśnie tutaj decyzje dotyczące modelu domenowego zaczynają bezpośrednio wpływać na zachowanie synchronizacji.
Aktualizacje aplikacji i kompatybilność
W aplikacji offline trzeba również uwzględnić fakt, że nie wszyscy użytkownicy muszą korzystać w tym samym momencie z tej samej wersji aplikacji.
Można wyróżnić kilka rodzajów zmian:
- zmiany kosmetyczne — np. modyfikacja wyglądu interfejsu,
- zmiany kompatybilne wstecz — które nie uniemożliwiają działania starszej wersji,
- zmiany potencjalnie niekompatybilne — które mogą wymagać aktualizacji klienta przed dalszą pracą.
W aplikacji działającej offline szczególnie ważne jest to, że użytkownik może rozpocząć pracę przed wdrożeniem nowej wersji, a próbę synchronizacji wykonać dopiero później.
Dlatego strategia aktualizacji powinna być częścią projektu aplikacji, a nie decyzją podejmowaną dopiero w momencie wdrożenia.
W zależności od architektury i wymagań aplikacji można stosować różne mechanizmy kontroli kompatybilności. Najważniejsze jest jednak wcześniejsze określenie, co powinno się wydarzyć ze starszym klientem próbującym zsynchronizować dane.
Co z danymi zebranymi offline?
To jeden z najważniejszych scenariuszy do przetestowania.
Użytkownik może zebrać dane bez połączenia z internetem, a następnie podczas próby synchronizacji napotkać problem — na przykład wynikający z niekompatybilnej wersji aplikacji albo konfliktu danych.
Z punktu widzenia użytkownika najważniejsze pytanie brzmi wtedy:
Czy moje dane nadal są bezpieczne?
Projektując aplikację offline-first, warto traktować ten scenariusz jako przypadek wymagający osobnego testowania.
Nie wystarczy sprawdzić, czy synchronizacja działa w idealnych warunkach. Należy również sprawdzić zachowanie aplikacji, gdy:
- urządzenie długo pozostaje offline,
- dane zostały zmienione na serwerze,
- użytkownik korzysta ze starszej wersji aplikacji,
- synchronizacja zakończy się błędem,
- wystąpi konflikt,
- zmieni się model danych lub konfiguracja synchronizacji.
To właśnie takie scenariusze pokazują, czy aplikacja offline-first jest rzeczywiście odporna na problemy z połączeniem.
Podsumowanie
Offline-first w Mendix to nie tylko kwestia „zapisz lokalnie, zsynchronizuj później”.
To zestaw decyzji, które warto podjąć już na etapie projektowania:
- jakie dane powinny być dostępne offline,
- który tryb synchronizacji pasuje do konkretnej encji,
- jak zachować się przy długotrwałej pracy offline,
- co zrobić w przypadku równoczesnych zmian danych,
- jak uwzględnić aktualizacje aplikacji i modelu danych,
- jak zapewnić bezpieczeństwo danych w przypadku nieudanej synchronizacji.
Największym błędem jest traktowanie synchronizacji jako mechanizmu, który po prostu „załatwia temat offline”.
Synchronizacja jest częścią większej architektury. Jeżeli zostanie zaprojektowana razem z modelem danych, strategią aktualizacji i obsługą konfliktów, aplikacja offline-first może działać przewidywalnie również wtedy, gdy urządzenie przez długi czas nie ma dostępu do sieci.
W kolejnych artykułach tej serii każdy z tych obszarów zostanie omówiony osobno — od różnicy między Nothing i Never, przez projektowanie modelu danych i selective synchronization, aż po konflikty oraz zachowanie lokalnych danych po redeployu.