Offline-first w Mendix: jak działa synchronizacja i jak uniknąć utraty danych
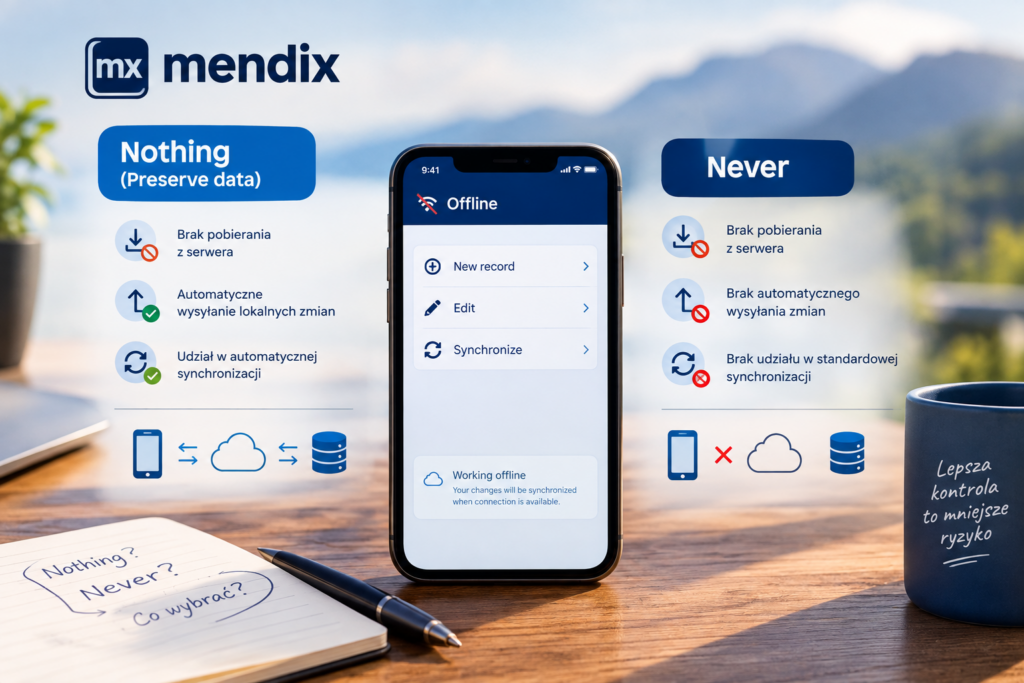
Jeśli konfigurujesz tryb synchronizacji dla encji w aplikacji offline-first w Mendix i wahasz się między Nothing (Preserve data) a Never, różnica może na pierwszy rzut oka wydawać się niewielka.
W praktyce oba tryby oznaczają jednak zupełnie inny sposób zarządzania lokalnymi danymi.
Najważniejsze pytanie nie brzmi więc:
Który tryb jest bezpieczniejszy?
Lepiej zapytać:
Który sposób synchronizacji lepiej pasuje do roli danej encji i tego, co powinno stać się z jej lokalnymi zmianami?
W tym artykule pokażę, czym Nothing (Preserve data) i Never różnią się w praktyce oraz jakie konsekwencje może mieć niewłaściwe założenie dotyczące ich działania.
Szybkie podsumowanie
Najważniejszą różnicę można przedstawić w kilku punktach:
Nothing (Preserve data) | Never | |
|---|---|---|
| Pobieranie danych z serwera | Zablokowane | Zablokowane |
| Automatyczne wysyłanie lokalnych zmian | Tak | Nie |
| Udział w automatycznej synchronizacji | Tak — w zakresie uploadu | Nie |
| Wysyłanie danych przez standardową synchronizację | Tak | Nie |
| Ręczna synchronizacja selektywna | Możliwa | Możliwa |
| Główne ryzyko | Niezamierzony upload lokalnych zmian | Utrata lokalnych danych, jeśli nie zostaną wcześniej zsynchronizowane |
| Typowe zastosowanie | Dane, które mogą być wysyłane na serwer, ale nie powinny być automatycznie pobierane | Dane wymagające pełnej kontroli nad momentem synchronizacji |
Najważniejsze zdanie tego artykułu brzmi:
Nothingnie oznacza „nic się nie synchronizuje”. Oznacza przede wszystkim, że dane nie są pobierane z serwera.
To właśnie ta różnica jest źródłem wielu nieporozumień podczas projektowania aplikacji offline-first.
Co faktycznie robi Nothing (Preserve data)?
Nazwa Nothing (Preserve data) może sugerować, że dana encja zostaje całkowicie wyłączona z synchronizacji.
Tak jednak nie jest.
W tym trybie:
- encja nie pobiera nowych ani zaktualizowanych obiektów z serwera,
- lokalne dane są zachowywane,
- lokalne zmiany mogą zostać wysłane na serwer,
- dotyczy to również lokalnych operacji usuwania,
- upload może nastąpić w ramach automatycznej synchronizacji.
To ostatnie zachowanie jest szczególnie istotne.
Można łatwo założyć:
„Ustawiłem
Nothing, więc będę sam decydował, kiedy ta encja zostanie zsynchronizowana.”
To założenie może być błędne.
Nothing kontroluje przede wszystkim pobieranie danych, a nie całkowite wyłączenie encji z synchronizacji.
Dlaczego ma to znaczenie?
Wyobraźmy sobie, że użytkownik pracuje offline i modyfikuje lokalne dane.
Jeżeli dana encja ma ustawione Nothing, lokalne zmiany mogą zostać przesłane na serwer podczas synchronizacji.
Oznacza to, że decyzja:
„Nie chcę teraz pobierać danych z serwera”
nie jest tym samym co:
„Nie chcę teraz wysyłać danych na serwer”.
To dwie różne decyzje.
Typowy scenariusz, w którym Nothing może zaskoczyć
Wyobraźmy sobie aplikację mobilną offline-first, która współdzieli dane z aplikacją webową.
Załóżmy, że część encji została skonfigurowana jako Nothing (Preserve data).
Zespół przyjmuje następujące założenia:
- dane będą przechowywane lokalnie,
- aplikacja nie będzie pobierała dla tych encji zmian z serwera,
- synchronizacja danych będzie kontrolowana przez logikę aplikacji,
- lokalne operacje nie powinny automatycznie wpływać na dane po stronie serwera.
Problem może pojawić się wtedy, gdy użytkownik lokalnie zmieni lub usunie obiekt.
Podczas automatycznej synchronizacji lokalna zmiana może zostać wysłana na serwer.
W efekcie:
zmiana lokalna → synchronizacja → upload → zmiana po stronie serwera
Jeżeli lokalne usunięcie miało jedynie ukryć rekord na urządzeniu mobilnym, a nie oznaczać jego usunięcie z systemu centralnego, może to prowadzić do niepożądanego efektu.
Nie jest to błąd działania Mendix.
Nothing działa zgodnie ze swoją konfiguracją.
Problemem jest założenie, że Nothing oznacza:
„ta encja nie będzie automatycznie synchronizowana”.
W rzeczywistości oznacza ono coś znacznie węższego.
Co faktycznie robi Never?
Never ma inne zachowanie.
W przypadku standardowych mechanizmów automatycznej synchronizacji encja ustawiona jako Never nie jest synchronizowana.
Oznacza to, że Mendix nie wykonuje dla niej automatycznego uploadu ani downloadu w ramach mechanizmów, które normalnie synchronizują dane.
To daje znacznie większą kontrolę nad tym, kiedy dane opuszczą urządzenie.
Jednocześnie pojawia się druga strona tego rozwiązania.
Jeżeli dane nie są synchronizowane automatycznie, odpowiedzialność za ich wysłanie na serwer przechodzi na logikę aplikacji.
W praktyce oznacza to:
Neverdaje większą kontrolę, ale wymaga większej odpowiedzialności po stronie aplikacji.
Dane można wysłać poprzez odpowiedni mechanizm ręcznej synchronizacji, np. synchronizację selektywną.
Jeżeli jednak taka synchronizacja nie zostanie wykonana w odpowiednim momencie, lokalne dane mogą pozostać wyłącznie na urządzeniu.
Never a aktualizacja aplikacji
To szczególnie ważny scenariusz w aplikacjach offline-first.
Załóżmy, że użytkownik:
- pobrał aplikację,
- pracował przez kilka godzin bez dostępu do sieci,
- utworzył nowe dane,
- dane zostały zapisane lokalnie,
- nie wykonał jeszcze synchronizacji selektywnej,
- aplikacja została zaktualizowana.
W przypadku zmian wymagających ponownego utworzenia lokalnej bazy danych urządzenia dane znajdujące się wyłącznie lokalnie mogą zostać usunięte.
Dla encji ustawionej jako Never problem jest szczególnie istotny, ponieważ automatyczny mechanizm synchronizacji nie wyśle tych danych na serwer przed takim procesem.
Może więc powstać następujący scenariusz:
dane utworzone offline → brak ręcznej synchronizacji → aktualizacja wymagająca resetu lokalnej bazy → lokalne dane zostają utracone
To pokazuje drugą stronę problemu.
Nothing może doprowadzić do niezamierzonego uploadu lokalnych zmian.
Never może natomiast doprowadzić do utraty lokalnych danych, jeżeli aplikacja nie zadba wcześniej o ich synchronizację.
Dlatego żaden z tych trybów nie powinien być oceniany jako po prostu „bezpieczniejszy”.
Nothing vs Never — dwa różne rodzaje odpowiedzialności
Można spojrzeć na oba tryby jeszcze inaczej.
Nothing
Mendix nadal może automatycznie wysłać lokalne zmiany.
Odpowiedzialność projektanta polega więc przede wszystkim na tym, aby upewnić się, że:
- lokalne zmiany mogą bezpiecznie trafić na serwer,
- lokalne usunięcia nie powodują niepożądanych zmian po stronie serwera,
- automatyczny upload jest akceptowalny dla danej encji.
Never
Mendix nie wysyła automatycznie zmian w ramach standardowej synchronizacji.
Odpowiedzialność aplikacji jest więc większa:
- trzeba określić, kiedy dane powinny zostać wysłane,
- trzeba wywołać odpowiednią synchronizację,
- trzeba uwzględnić sytuację braku połączenia,
- trzeba zabezpieczyć dane przed utratą w przypadku aktualizacji aplikacji.
W skrócie:
Nothingdaje mniejszą kontrolę nad momentem uploadu, ale zmniejsza ryzyko pozostawienia danych wyłącznie lokalnie.
Neverdaje większą kontrolę nad uploadem, ale zwiększa odpowiedzialność aplikacji za bezpieczne zapisanie danych na serwerze.
Jak podjąć decyzję?
Zamiast zaczynać od pytania:
„Czy powinienem użyć
Nothing, czyNever?”
warto zacząć od kilku prostszych pytań.
Czy lokalne zmiany mogą automatycznie trafić na serwer?
Jeżeli tak, Nothing może być odpowiednim rozwiązaniem.
Jeżeli nie, warto rozważyć Never i przejąć kontrolę nad momentem synchronizacji.
Czy dane muszą być zachowane lokalnie do czasu świadomej synchronizacji?
Jeżeli tak, Never może być właściwym wyborem — ale tylko wtedy, gdy aplikacja ma mechanizm, który zagwarantuje synchronizację danych w odpowiednim momencie.
Samo ustawienie Never nie rozwiązuje problemu.
Czy lokalne usunięcie oznacza usunięcie danych na serwerze?
Jeżeli odpowiedź brzmi nie, trzeba szczególnie uważać na Nothing.
Lokalne operacje usuwania są nadal zmianami, które mogą zostać wysłane na serwer.
W takim scenariuszu warto zastanowić się również nad sposobem reprezentowania usunięcia danych, zamiast traktować fizyczne usunięcie jako jedyny sposób ukrycia rekordu na urządzeniu.
Prosty sposób myślenia o Nothing i Never
Możesz zapamiętać to w ten sposób:
Nothing
„Nie pobieraj danych, ale moje lokalne zmiany nadal mogą zostać wysłane.”
Never
„Nie synchronizuj tej encji automatycznie. Ja decyduję, kiedy dane zostaną wysłane.”
To znacznie lepszy sposób myślenia o tych trybach niż interpretowanie ich nazw.
Czy Never oznacza, że danych nie można zsynchronizować?
Nie.
To ważne rozróżnienie.
Never nie oznacza:
„dane nigdy nie mogą trafić na serwer”.
Oznacza raczej:
„dane nie uczestniczą w standardowej automatycznej synchronizacji”.
Jeżeli aplikacja wymaga wysłania takich danych, może wykorzystać mechanizmy pozwalające na świadome, selektywne sterowanie synchronizacją.
To właśnie daje Never zastosowanie w scenariuszach, w których dane powinny zostać zweryfikowane lub przygotowane przed wysłaniem na serwer.
A co z danymi roboczymi?
To jeden z ciekawszych przypadków zastosowania Never.
Wyobraźmy sobie dane, które użytkownik tworzy podczas pracy offline, ale które nie powinny jeszcze trafić do centralnego systemu.
Może to być na przykład formularz będący dopiero w trakcie wypełniania.
W takim przypadku automatyczny upload może być niepożądany.
Można wtedy potraktować dane jako lokalne dane robocze i zdecydować, że dopiero określone zdarzenie — np. zakończenie pracy nad formularzem — pozwoli na ich synchronizację.
Trzeba jednak pamiętać, że wraz z takim podejściem pojawia się dodatkowa odpowiedzialność za obsługę:
- braku połączenia,
- ponownej synchronizacji,
- błędów synchronizacji,
- aktualizacji aplikacji,
- danych, które pozostają lokalnie przez dłuższy czas.
Never nie usuwa tych problemów.
Po prostu pozwala świadomie nimi zarządzać.
Czy można ograniczyć ryzyko utraty danych przy Never?
Tak — kluczowe jest, aby synchronizacja nie zależała wyłącznie od tego, czy użytkownik pamięta o wykonaniu odpowiedniej akcji.
W zależności od projektu można rozważyć synchronizację danych w określonych momentach, np.:
- po zakończeniu pracy nad formularzem,
- po zatwierdzeniu danych przez użytkownika,
- po zakończeniu określonego procesu,
- po odzyskaniu połączenia,
- cyklicznie, gdy aplikacja ma dostęp do sieci.
Nie eliminuje to całkowicie ryzyka, ale pozwala ograniczyć ilość danych, które przez długi czas pozostają wyłącznie na urządzeniu.
Najważniejszy wniosek: problem nie kończy się na wyborze trybu
Nothing i Never są ustawieniami synchronizacji.
Nie zastępują jednak decyzji dotyczących całej architektury aplikacji offline-first.
Jeżeli encja jest bezpośrednio współdzielona pomiędzy aplikacją mobilną i webową, sam wybór trybu synchronizacji może jedynie przesunąć problem.
Przykładowo:
Nothingmoże spowodować niezamierzony upload lokalnej zmiany,Nevermoże pozostawić zmianę wyłącznie na urządzeniu,- konflikt zmian może wymagać dodatkowej obsługi,
- aktualizacja aplikacji może wpłynąć na lokalne dane,
- model danych może utrudnić bezpieczne rozdzielenie danych roboczych i produkcyjnych.
Dlatego wybór Nothing lub Never powinien być częścią większej decyzji dotyczącej modelu danych i sposobu synchronizacji.
W bardziej złożonych aplikacjach warto rozważyć rozdzielenie danych roboczych aplikacji mobilnej od danych docelowych wykorzystywanych przez aplikację webową. Pozwala to ograniczyć sytuacje, w których pojedyncza lokalna operacja bezpośrednio modyfikuje dane produkcyjne.
Temu zagadnieniu poświęcę osobny artykuł o projektowaniu modelu danych dla aplikacji offline-first.
Podsumowanie
Nothing (Preserve data) i Never mogą wyglądać podobnie, ale prowadzą do zupełnie różnych modeli synchronizacji.
Nothing:
- blokuje pobieranie danych,
- zachowuje lokalne dane,
- pozwala na automatyczny upload lokalnych zmian,
- wymaga ostrożności przy lokalnych usunięciach.
Never:
- wyłącza encję ze standardowej automatycznej synchronizacji,
- nie wysyła lokalnych zmian automatycznie,
- pozwala świadomie kontrolować moment synchronizacji,
- wymaga zadbania o synchronizację danych przed sytuacjami, w których lokalna baza może zostać zresetowana.
Dlatego nie warto traktować tego wyboru jako:
NothingvsNever= bezpieczne vs niebezpieczne.
Lepsze pytanie brzmi:
Czy w przypadku tej konkretnej encji większym problemem jest niezamierzony upload lokalnej zmiany, czy ryzyko pozostawienia danych wyłącznie na urządzeniu?
To właśnie odpowiedź na to pytanie powinna prowadzić do wyboru odpowiedniego trybu.
A jeśli odpowiedź jest trudna, prawdopodobnie problem leży głębiej — w sposobie zaprojektowania modelu danych i całej strategii offline-first.
Co dalej?
W kolejnym artykule przyjrzymy się jednemu z najbardziej problematycznych scenariuszy w aplikacjach offline-first:
co dzieje się z lokalnymi danymi po redeployu aplikacji i zmianie modelu danych?
To właśnie wtedy różnice pomiędzy poszczególnymi trybami synchronizacji mogą mieć największe znaczenie.